
KRX 상장 종목 시가총액 장기 시계열 분석 (1995–2026)

Data
Macro
오픈소스 시가총액 데이터셋(marcap)과 DuckDB를 활용하여 1995년부터 2026년까지 코스피와 코스닥의 자본 집중도, 시총 5분위 규모 효과, 신규 상장 생존성을 실증 분석한다.
Author

gitSAM

Published

November 10, 2026

1 연구 배경 및 문제 정의

한국거래소(KRX, Korea Exchange) 공식 포털이 제공하는 고정 금액 구간별 시가총액 분포는 명목적 화폐 가치 하락과 주식시장의 외형적 성장을 반영하지 못한다. 10년 전 1조 원과 현재 1조 원의 시장 내 위상이 다름에도 동일한 명목 금액 격자(Fixed Nominal Bin)를 적용하면, 외형 성장에 따른 단순 우측 이동(Base Drift)과 실제 자본 쏠림을 구분할 수 없다. 특정 일자의 횡단면 현황 (Cross-sectional Snapshot)만으로는 자본이 대형주로 수렴하는 속도나 시장 체제 변화(Regime Shift)도 관측하기 어렵다.

KRX 시장 시가총액 오픈소스 데이터셋(marcap, 1995년~2026년)을 이용하여 코스피(KOSPI) 및 코스닥(KOSDAQ) 시장의 3가지 구조적 특성을 규명해 본다.

  • 자본 집중도(Capital Concentration): 전체 시가총액에서 상위 종목이 차지하는 비중과 불평등도의 장기 시계열 추이
  • 규모 효과(Size Effect): 소속시장별 시가총액 상위(대형주)와 하위(소형주) 집단 간 수익률 분포(중위값 및 사분위 범위) 차이의 변화
  • 상장 생존성(Survivorship): 소속시장별 신규 상장 초기 시가총액 규모에 따른 상장 유지기간, 상장 후 최고점(Peak) 및 최저점(Trough) 도달 기간 분포

코스피(KOSPI), 코스닥(KOSDAQ) 시장에 상장된 주식들 중 일별 거래량이 0보다 큰 유효 거래대상만 분석 대상으로 삼는다.

Code
import duckdb
import pandas as pd
import numpy as np
import altair as alt
import matplotlib.pyplot as plt

alt.data_transformers.disable_max_rows()
MARKET_ORDER = ['KOSPI', 'KOSDAQ']

con = duckdb.connect()
con.execute("PRAGMA disable_progress_bar;")
PARQUET_GLOB = "marcap/data/marcap-*.parquet"

# 데이터셋 기간 및 시장별 기초 통계 확인
summary_df = con.execute(f"""
    SELECT 
        Market,
        MIN(Date) AS min_date,
        MAX(Date) AS max_date,
        COUNT(*) AS total_rows,
        COUNT(DISTINCT Code) AS unique_stocks
    FROM '{PARQUET_GLOB}'
    WHERE Market IN ('KOSPI', 'KOSDAQ')
      AND Volume > 0
    GROUP BY Market
    ORDER BY CASE WHEN Market = 'KOSPI' THEN 1 ELSE 2 END
""").df()

print(summary_df)
   Market   min_date   max_date  total_rows  unique_stocks
0   KOSPI 1995-05-02 2026-11-06     6969227           2942
1  KOSDAQ 1996-07-01 2026-11-06     7525909           3684
Code
# 일별 시장별 합산 시가총액 집계 (조 원 단위)
mcap_ts_df = con.execute(f"""
    SELECT 
        Date,
        Market,
        SUM(Marcap) / 1e12 AS total_marcap_trillion
    FROM '{PARQUET_GLOB}'
    WHERE Market IN ('KOSPI', 'KOSDAQ')
      AND Volume > 0
    GROUP BY Date, Market
    ORDER BY Date
""").df()

mcap_pivot = mcap_ts_df.pivot(index='Date', columns='Market', values='total_marcap_trillion')

plt.rcParams['font.family'] = ['Noto Sans CJK JP', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

fig, ax = plt.subplots(figsize=(10, 4.6), dpi=150)
if 'KOSPI' in mcap_pivot.columns:
    ax.plot(mcap_pivot.index, mcap_pivot['KOSPI'], label='KOSPI', color='#1f77b4', linewidth=1.2)
if 'KOSDAQ' in mcap_pivot.columns:
    ax.plot(mcap_pivot.index, mcap_pivot['KOSDAQ'], label='KOSDAQ', color='#ff7f0e', linewidth=1.2)

ax.set_title('KOSPI 및 KOSDAQ 일별 합산 시가총액 추이 (1995–2026)', fontsize=12, pad=12)
ax.set_xlabel('Date', fontsize=10)
ax.set_ylabel('합산 시가총액 (조 원, Trillion KRW)', fontsize=10)
ax.grid(True, linestyle='--', alpha=0.5)
ax.legend(frameon=True, facecolor='white', framealpha=0.9)
plt.tight_layout()
plt.show()
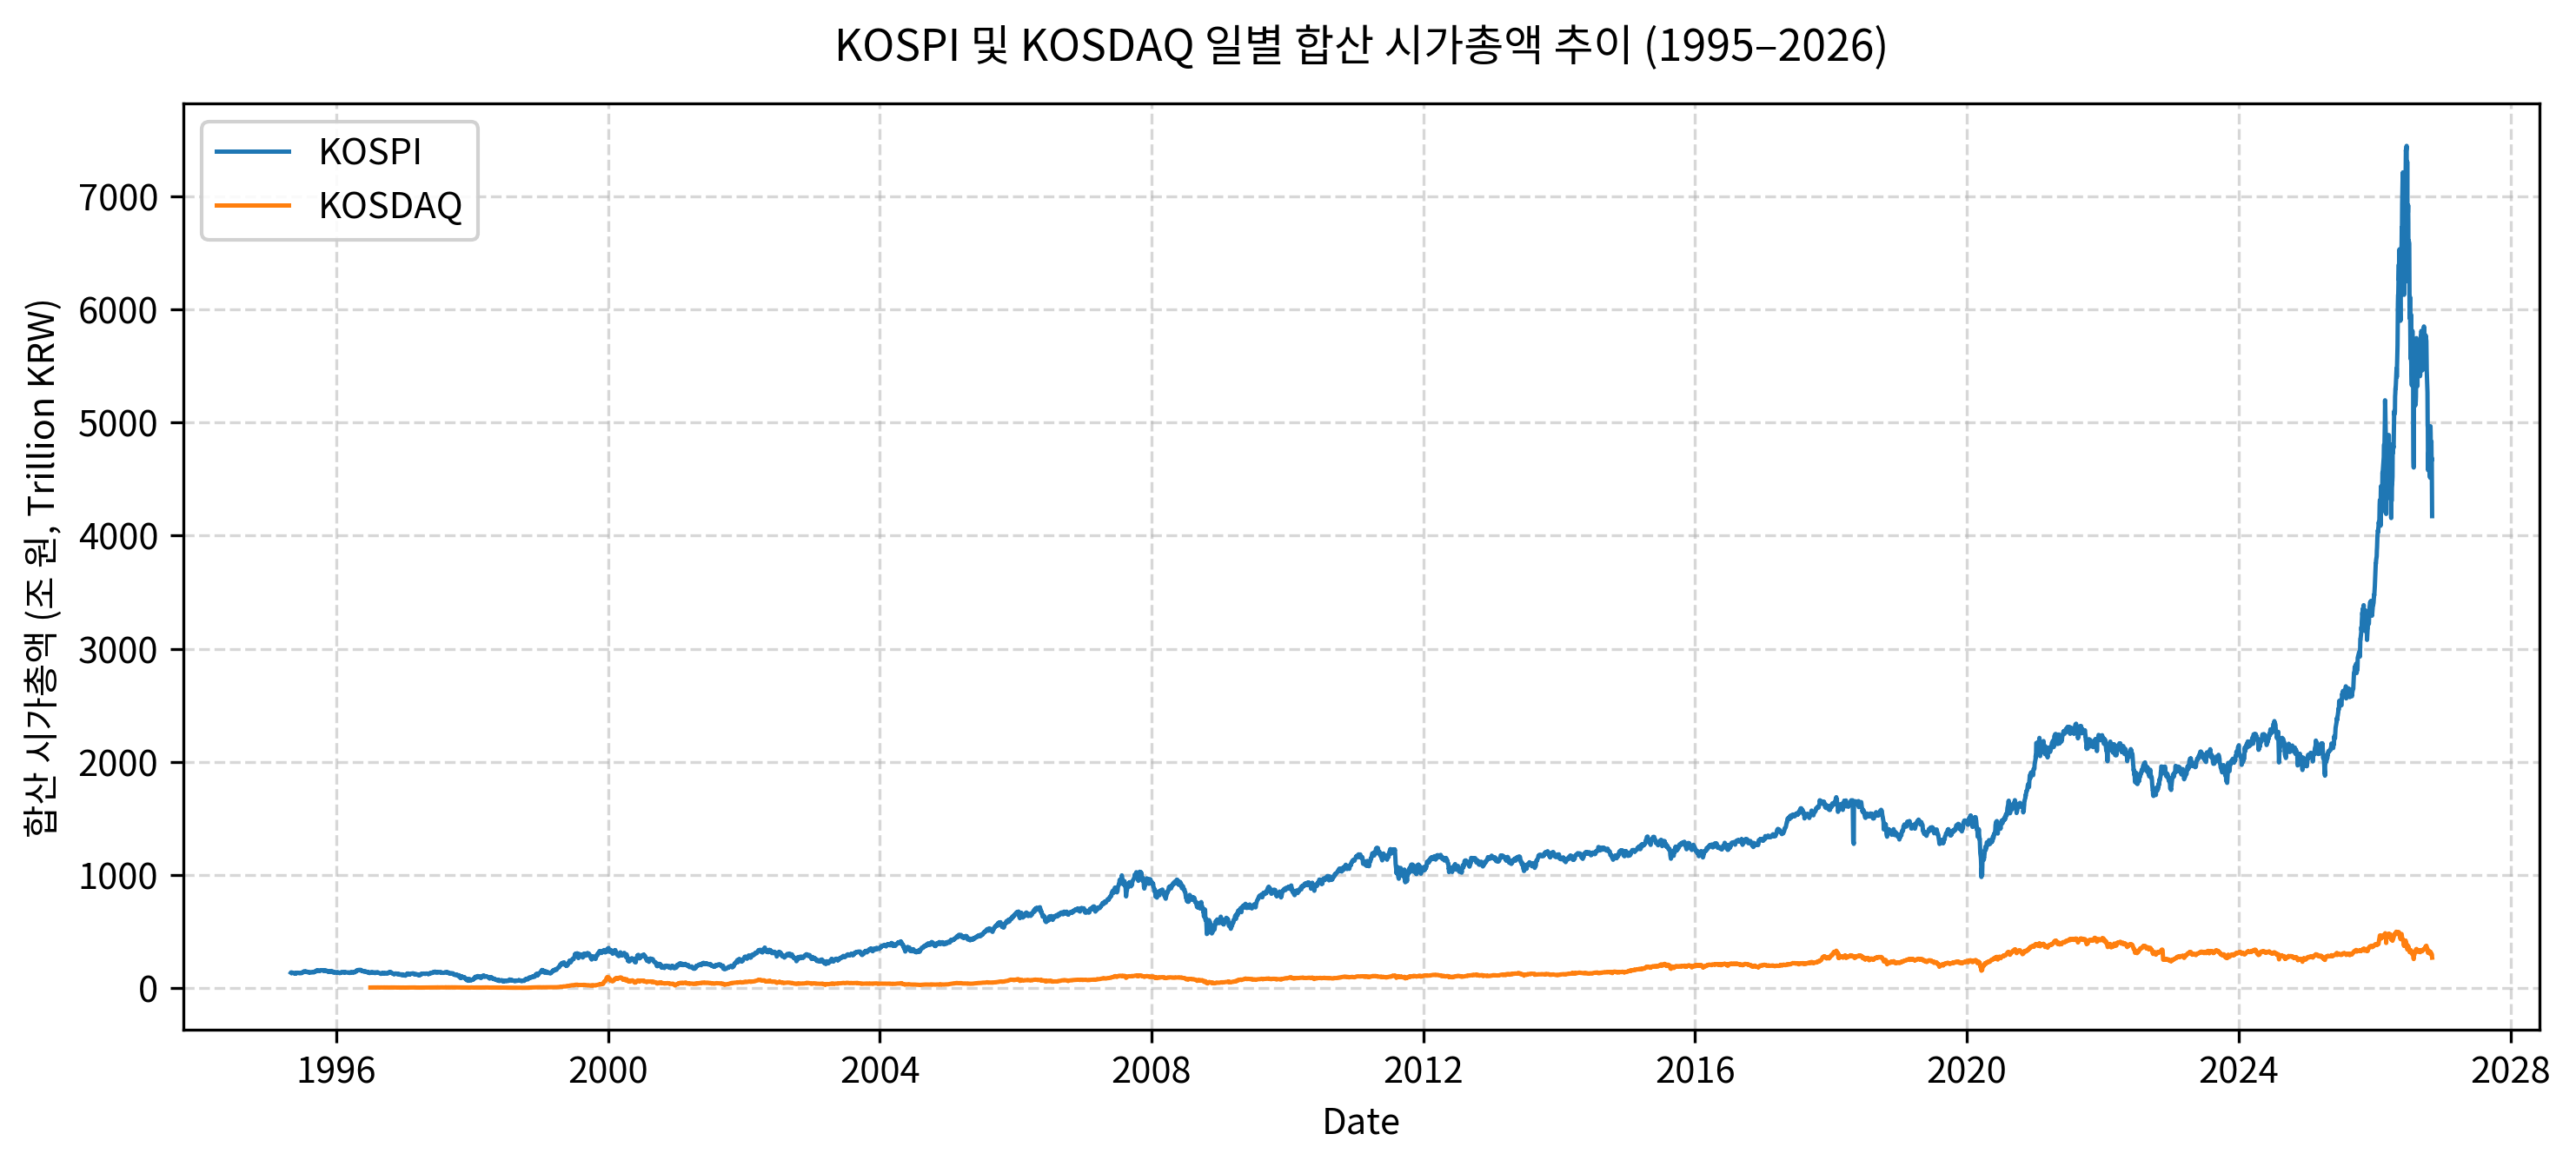
Figure 1: KOSPI 및 KOSDAQ 일별 합산 시가총액 장기 시계열 추이 (1995–2026)

유효 거래일(거래량 0 초과) 기준

  • 코스피(KOSPI)는 1995-05-02부터 2026-11-06까지 총 6,969,227건(고유 종목 2,942개),
  • 코스닥(KOSDAQ)은 시장 개설일인 1996-07-01부터 2026-11-06까지 총 7,525,909건(고유 종목 3,684개)으로

합산 1,449만 5,136행의 일별 시세 레코드가 확인된다.


2 소속시장별 자본 집중도(Capital Concentration) 추이

2.1 측정 지표 정의

시점 간 상장 종목 수 변동과 명목 화폐 가치 차이를 제거하기 위해 개별 종목의 위치를 상대 백분위 순위(Percentile Rank)로 정규화(Normalization)한다.

  • 백분위 순위 정규화: 각 시점 \(t\)의 유효 상장 종목 수 \(N_t\)에 대해 시가총액 내림차순 순위를 \(r_i\)라 할 때, 상대 위치를 \(p_i = \frac{r_i}{N_t}\)로 정의한다.
  • 상위 집중도 비율(CR, Concentration Ratio): 상위 1%(\(CR_{1\%}\)), 상위 5%(\(CR_{5\%}\)), 상위 10%(\(CR_{10\%}\)) 종목의 합산 시가총액이 시장 전체 시가총액에서 차지하는 비중을 산출한다.
  • 지니계수(Gini Coefficient): 시점 \(t\)의 오름차순 정렬된 시가총액 \(\text{MCAP}_{t,(i)}\)에 대해 자본 불평등도를 단일 스칼라 값으로 도출한다. \[G_t = \frac{2 \sum_{i=1}^{N_t} i \cdot \text{MCAP}_{t,(i)}}{N_t \sum_{i=1}^{N_t} \text{MCAP}_{t,(i)}} - \frac{N_t + 1}{N_t}\]
  • 허핀달-허쉬만 지수(HHI, Herfindahl-Hirschman Index): 개별 종목의 시장 점유율 \(s_{i,t} = \frac{\text{MCAP}_{i,t}}{\sum_{j=1}^{N_t} \text{MCAP}_{j,t}}\)의 제곱합을 통해 최상위 초대형주의 독과점 지배력을 포착한다. \[\text{HHI}_t = \sum_{i=1}^{N_t} s_{i,t}^2\]

2.2 연도별 집중도 지표

각 연도 마지막 거래일 스냅샷을 기준으로 시장별(\(\text{KOSPI}\), \(\text{KOSDAQ}\)) 집중도 지표와 로렌츠 곡선(Lorenz Curve) 데이터를 추출한다.

Code
# 1) 연도 말일 기준 CR_k, Gini, HHI 시계열 산출
concentration_df = con.execute(f"""
    WITH YearEndDates AS (
        SELECT EXTRACT(YEAR FROM Date) AS yr, MAX(Date) AS max_date
        FROM '{PARQUET_GLOB}'
        WHERE Volume > 0
        GROUP BY EXTRACT(YEAR FROM Date)
    ),
    Ranked AS (
        SELECT 
            EXTRACT(YEAR FROM m.Date) AS yr,
            m.Date,
            m.Market,
            m.Code,
            m.Name,
            m.Marcap,
            ROW_NUMBER() OVER (PARTITION BY m.Date, m.Market ORDER BY m.Marcap DESC) AS rank_desc,
            ROW_NUMBER() OVER (PARTITION BY m.Date, m.Market ORDER BY m.Marcap ASC) AS rank_asc,
            COUNT(*) OVER (PARTITION BY m.Date, m.Market) AS n_stocks,
            SUM(m.Marcap) OVER (PARTITION BY m.Date, m.Market) AS total_marcap
        FROM '{PARQUET_GLOB}' m
        JOIN YearEndDates y ON m.Date = y.max_date
        WHERE m.Market IN ('KOSPI', 'KOSDAQ')
          AND m.Volume > 0
    )
    SELECT 
        yr,
        Date,
        Market,
        MAX(n_stocks) AS n_stocks,
        SUM(CASE WHEN rank_desc::DOUBLE / n_stocks <= 0.01 THEN Marcap ELSE 0 END) / MAX(total_marcap) AS cr_01,
        SUM(CASE WHEN rank_desc::DOUBLE / n_stocks <= 0.05 THEN Marcap ELSE 0 END) / MAX(total_marcap) AS cr_05,
        SUM(CASE WHEN rank_desc::DOUBLE / n_stocks <= 0.10 THEN Marcap ELSE 0 END) / MAX(total_marcap) AS cr_10,
        (2.0 * SUM(rank_asc * Marcap) / (MAX(n_stocks) * MAX(total_marcap))) - ((MAX(n_stocks) + 1.0) / MAX(n_stocks)) AS gini,
        SUM(POWER(Marcap / total_marcap, 2)) AS hhi
    FROM Ranked
    GROUP BY yr, Date, Market
    ORDER BY CASE WHEN Market = 'KOSPI' THEN 1 ELSE 2 END, yr
""").df()
Code
# 2) 로렌츠 곡선(Lorenz Curve) 비교용 주요 연도 누적 분포 추출 (1997, 2005, 2015, 2026)
lorenz_df = con.execute(f"""
    WITH TargetDates AS (
        SELECT EXTRACT(YEAR FROM Date) AS yr, MAX(Date) AS max_date
        FROM '{PARQUET_GLOB}'
        WHERE EXTRACT(YEAR FROM Date) IN (1997, 2005, 2015, 2026)
          AND Volume > 0
        GROUP BY EXTRACT(YEAR FROM Date)
    ),
    Ordered AS (
        SELECT 
            t.yr,
            m.Market,
            m.Marcap,
            ROW_NUMBER() OVER (PARTITION BY t.yr, m.Market ORDER BY m.Marcap ASC) AS rank_asc,
            COUNT(*) OVER (PARTITION BY t.yr, m.Market) AS n_stocks,
            SUM(m.Marcap) OVER (PARTITION BY t.yr, m.Market) AS total_marcap
        FROM '{PARQUET_GLOB}' m
        JOIN TargetDates t ON m.Date = t.max_date
        WHERE m.Market IN ('KOSPI', 'KOSDAQ')
          AND m.Volume > 0
    )
    SELECT 
        yr,
        Market,
        rank_asc::DOUBLE / n_stocks AS cum_pop_share,
        SUM(Marcap / total_marcap) OVER (
            PARTITION BY yr, Market 
            ORDER BY rank_asc 
            ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
        ) AS cum_marcap_share
    FROM Ordered
    ORDER BY CASE WHEN Market = 'KOSPI' THEN 1 ELSE 2 END, yr, rank_asc
""").df()

2.3 시각화 및 해석

Code
# 1) 연도별 상위 집중도 비율(CR_1%, CR_5%, CR_10%) 및 지니계수(Gini) 시계열 라인 차트
cr_melted = concentration_df.melt(
    id_vars=['yr', 'Market'],
    value_vars=['cr_01', 'cr_05', 'cr_10', 'gini'],
    var_name='metric',
    value_name='value'
)
metric_labels = {
    'cr_01': '상위 1% 비중 (CR 1%)',
    'cr_05': '상위 5% 비중 (CR 5%)',
    'cr_10': '상위 10% 비중 (CR 10%)',
    'gini': '지니계수 (Gini)'
}
metric_order = [
    '지니계수 (Gini)',
    '상위 10% 비중 (CR 10%)',
    '상위 5% 비중 (CR 5%)',
    '상위 1% 비중 (CR 1%)'
]
cr_melted['metric_label'] = cr_melted['metric'].map(metric_labels)

chart_cr = alt.Chart(cr_melted).mark_line(point=True).encode(
    x=alt.X('yr:Q', title='연도', axis=alt.Axis(format='d')),
    y=alt.Y('value:Q', title='지표값', scale=alt.Scale(domain=[0, 1])),
    color=alt.Color(
        'metric_label:N',
        title='지표',
        sort=metric_order,
        legend=alt.Legend(orient='top')
    ),
    column=alt.Column('Market:N', title='시장', sort=MARKET_ORDER),
    tooltip=[
        alt.Tooltip('Market:N', title='시장'),
        alt.Tooltip('yr:Q', title='연도', format='d'),
        alt.Tooltip('metric_label:N', title='지표'),
        alt.Tooltip('value:Q', title='지표값', format='.2f')
    ]
).properties(
    width=320,
    height=280,
    title='KOSPI vs KOSDAQ 연도별 Gini Index 및 CR 추이 (1995–2026)'
)
chart_cr
Code
# 2) 허핀달-허쉬만 지수(HHI) 추이 및 초대형주 지배력 시계열 차트
chart_hhi = alt.Chart(concentration_df).mark_line(point=True).encode(
    x=alt.X('yr:Q', title='연도', axis=alt.Axis(format='d')),
    y=alt.Y('hhi:Q', title='HHI 지수'),
    color=alt.Color('Market:N', title='시장', sort=MARKET_ORDER),
    tooltip=[
        alt.Tooltip('Market:N', title='시장'),
        alt.Tooltip('yr:Q', title='연도', format='d'),
        alt.Tooltip('hhi:Q', title='HHI 지수', format='.2f')
    ]
).properties(
    width=660,
    height=280,
    title='소속시장별 HHI 추이 (초대형주 과점도)'
)
chart_hhi
Code
# 3) 주요 연도별(1997, 2005, 2015, 2026) 로렌츠 곡선(Lorenz Curve) 비교
base_lorenz = alt.Chart(lorenz_df)

lorenz_line = base_lorenz.mark_line().encode(
    x=alt.X('cum_pop_share:Q', title='누적 종목 수 비중 (하위 -> 상위)', scale=alt.Scale(domain=[0, 1])),
    y=alt.Y('cum_marcap_share:Q', title='누적 시가총액 비중', scale=alt.Scale(domain=[0, 1])),
    color=alt.Color('yr:N', title='연도', sort=['1997', '2005', '2015', '2026']),
    tooltip=[
        alt.Tooltip('Market:N', title='시장'),
        alt.Tooltip('yr:N', title='연도'),
        alt.Tooltip('cum_pop_share:Q', title='누적 종목 비중', format='.2%'),
        alt.Tooltip('cum_marcap_share:Q', title='누적 시총 비중', format='.2%')
    ]
)

diag_line = base_lorenz.mark_line(strokeDash=[4, 4], color='gray').encode(
    x='cum_pop_share:Q',
    y='cum_pop_share:Q'
)

chart_lorenz = alt.layer(diag_line, lorenz_line).properties(
    width=320,
    height=280
).facet(
    column=alt.Column('Market:N', title='시장', sort=MARKET_ORDER)
).properties(
    title='주요 연도별 로렌츠 곡선(Lorenz Curve) 궤적 변화'
)
chart_lorenz

2.4 실증 분석 해석

  • KOSPI 시장의 자본 집중 심화와 역대 최고치 경신: 1995년 말 기준 코스피(1,001개 종목)의 \(CR_{1\%}\)는 33.26%, \(CR_{10\%}\)는 68.51%, 지니계수는 0.7765였다. 외환위기 직후 부실 기업 퇴출과 IT·통신 대형주 랠리가 맞물린 1999~2000년에 \(CR_{1\%}\)가 57.56%, 지니계수가 0.9131로 1차 급등했다. 이후 2015년 \(CR_{1\%}\) 30.00%(지니계수 0.8417)까지 완화되었으나, 팬데믹 유동성 장세(2020년 \(CR_{1\%}\) 46.76%)와 AI·반도체 중심의 초대형주 장세를 거치며 2026년 11월 기준 \(CR_{1\%}\) 59.22%, \(CR_{5\%}\) 80.53%, \(CR_{10\%}\) 89.71%, 지니계수 0.9245로 1995년 이래 최고치를 경신했다.
  • 삼전+닉스 양강 체제 고착화와 HHI 스파이크: 2026년 11월 기준 코스피 1위 삼성전자(1,103.19조 원, 점유율 26.44%, 우선주 2.89% 별도)와 2위 SK하이닉스(826.92조 원, 점유율 19.82%) 두 기업의 합산 시총이 코스피 전체의 49.15%를 차지한다. 이로 인해 코스피 HHI는 1995년 0.0270에서 2026년 0.1135로 4.2배 급등했다.
  • KOSDAQ 시장의 체제 변화(Regime Shift)와 다극화: 코스닥은 1999년 말 벤처·닷컴 버블 정점 당시 1위 한통프리텔(37.43조 원, 점유율 38.92%)과 한통엠닷컴(7.37%), 하나로통신(4.90%), 새롬기술(3.02%) 등 소수 통신·인터넷주로 자금이 쏠리며 \(CR_{1\%}\) 54.21%, 지니계수 0.8731, HHI 0.1639라는 이례적 수치를 기록했다. 그러나 2000년 버블 붕괴 직후 지니계수가 0.5848, HHI가 0.0157로 급락했으며, 이후 우량 대장주의 유가증권시장 이전 상장이 반복되면서 2026년 11월 기준 지니계수 0.6564, \(CR_{1\%}\) 16.69%, HHI 0.0036(1위 레인보우로보틱스 점유율 2.32%)의 분산된 시장 구조를 유지한다.
  • 로렌츠 곡선의 비대칭적 우하단 이동: 코스피 로렌츠 곡선은 1997년 대비 2026년에 우하단 모서리로 강하게 밀착되며, 하위 90% 종목(약 820개)의 합산 시총 비중이 10.29%에 그치는 극단적 파레토 분포를 실증한다.

3 소속시장별 규모 효과(Size Effect)와 수익률 분포 차이

3.1 분석 설계

소속시장(KOSPI, KOSDAQ)별로 시가총액 상위 집단(대형주)과 하위 집단(소형주) 간 수익률 분포가 어떻게 다른지 검증한다. 평균 수익률은 소수 급등주의 우측 꼬리(Right-skewness)에 의해 왜곡되므로, 중위값(Median)과 사분위 범위(IQR, Interquartile Range)를 중심으로 비교한다.

  • 그룹 분류 기준: 매 연도 첫 거래일 시가총액을 기준으로 시장별 5분위수(Quintile, 5분위) 그룹으로 할당한다.
    • Q1 (Large-cap): 상위 20% (대형주)
    • Q2 (Mid-Large): 상위 20% ~ 40% (중대형주)
    • Q3 (Mid-cap): 상위 40% ~ 60% (중형주)
    • Q4 (Mid-Small): 상위 60% ~ 80% (중소형주)
    • Q5 (Small-cap): 하위 20% (소형주)
  • 수익률 산출 및 권리락 보정: 원천 데이터의 Close는 수정주가가 아닌 당일 명목 종가이므로, 연중 액면분할이나 무상증자가 발생하면 명목 주가가 급락하는 왜곡이 생긴다(예: 2018년 삼성전자 50:1 액면분할). 이를 보정하기 위해 한국거래소가 액면분할·무상증자·배당락 기준가를 반영하여 고시하는 일별 등락률(ChangesRatio, 단위 %)을 연간 복리 누적한 실질 주가 수익률(compound_return)과 연간 시가총액 성장률(marcap_return)을 병행 산출한다.

3.2 시총 5분위별 연간 수익률

Code
# 1) 개별 연도·종목 단위 수익률 및 5분위 관측치 테이블
size_obs_df = con.execute(f"""
    WITH YearlyBounds AS (
        SELECT 
            EXTRACT(YEAR FROM Date) AS yr,
            Market,
            Code,
            ARG_MIN(Name, Date) AS Name,
            ARG_MIN(Marcap, Date) AS start_marcap,
            ARG_MAX(Marcap, Date) AS end_marcap,
            ARG_MIN(Close, Date) AS start_close,
            ARG_MAX(Close, Date) AS end_close,
            EXP(SUM(LN(GREATEST(1.0 + COALESCE(ChangesRatio, 0) / 100.0, 0.0001)))) - 1.0 AS compound_return,
            MIN(Date) AS first_trade_date,
            MAX(Date) AS last_trade_date,
            COUNT(*) AS trading_days
        FROM '{PARQUET_GLOB}'
        WHERE Market IN ('KOSPI', 'KOSDAQ')
          AND Volume > 0
        GROUP BY EXTRACT(YEAR FROM Date), Market, Code
    )
    SELECT 
        yr,
        Market,
        Code,
        Name,
        CASE 
            WHEN yr < 2000 THEN '1990년대'
            WHEN yr < 2010 THEN '2000년대'
            WHEN yr < 2020 THEN '2010년대'
            ELSE '2020년대'
        END AS decade,
        NTILE(5) OVER (PARTITION BY yr, Market ORDER BY start_marcap DESC) AS size_quintile,
        compound_return,
        (end_close - start_close) / NULLIF(start_close, 0) AS close_return,
        (end_marcap - start_marcap) / NULLIF(start_marcap, 0) AS marcap_return
    FROM YearlyBounds
    WHERE trading_days >= 200  -- 연중 정상 거래 종목 필터링
""").df()

quintile_labels = {
    1: 'Q1 (대형주)',
    2: 'Q2 (중대형)',
    3: 'Q3 (중형주)',
    4: 'Q4 (중소형)',
    5: 'Q5 (소형주)'
}
size_obs_df['quintile_name'] = size_obs_df['size_quintile'].map(quintile_labels)

# 2) 시장별·5분위별 요약 통계 테이블
size_summary_df = con.execute("""
    SELECT 
        Market,
        size_quintile,
        COUNT(*) AS stock_year_obs,
        ROUND(MEDIAN(compound_return), 4) AS med_compound_ret,
        ROUND(QUANTILE_CONT(compound_return, 0.25), 4) AS q25_compound_ret,
        ROUND(QUANTILE_CONT(compound_return, 0.75), 4) AS q75_compound_ret,
        ROUND(AVG(compound_return), 4) AS mean_compound_ret,
        ROUND(MEDIAN(marcap_return), 4) AS med_marcap_ret,
        ROUND(AVG(marcap_return), 4) AS mean_marcap_ret
    FROM size_obs_df
    GROUP BY Market, size_quintile
    ORDER BY CASE WHEN Market = 'KOSPI' THEN 1 ELSE 2 END, size_quintile
""").df()

size_summary_df['quintile_name'] = size_summary_df['size_quintile'].map(quintile_labels)
3.3 시각화 및 해석

Code
# 1) 소속시장별·시총 5분위 연간 복리 수익률 분포 박스플롯 (이상치 왜곡 방지를 위해 y축 범위 설정)
quintile_order = ['Q5 (소형주)', 'Q4 (중소형)', 'Q3 (중형주)', 'Q2 (중대형)', 'Q1 (대형주)']

chart_size_box = alt.Chart(size_obs_df).mark_boxplot(outliers=False, clip=True).encode(
    x=alt.X('quintile_name:N', title='시총 5분위 그룹 (소형 -> 대형)', sort=quintile_order),
    y=alt.Y(
        'compound_return:Q',
        title='연간 복리 주가 수익률',
        scale=alt.Scale(domain=[-1.0, 2.0]),
        axis=alt.Axis(format='.2f')
    ),
    color=alt.Color('Market:N', sort=MARKET_ORDER, legend=None),
    column=alt.Column('Market:N', title='시장', sort=MARKET_ORDER)
).properties(
    width=320,
    height=280,
    title='소속시장별 시가총액 5분위(Q5~Q1) 연간 복리 수익률 분포 (1995–2026)'
)
chart_size_box
Code
# 2) 시대별 대형주(Q1) 대비 소형주(Q5) 중위 수익률 스프레드 추이
decade_spread_df = con.execute("""
    WITH GroupMedians AS (
        SELECT 
            decade,
            yr,
            Market,
            MEDIAN(CASE WHEN size_quintile = 1 THEN compound_return END) AS q1_median,
            MEDIAN(CASE WHEN size_quintile = 5 THEN compound_return END) AS q5_median
        FROM size_obs_df
        GROUP BY decade, yr, Market
    )
    SELECT 
        decade,
        Market,
        AVG(q1_median - q5_median) AS avg_size_spread,
        MEDIAN(q1_median) AS q1_med_overall,
        MEDIAN(q5_median) AS q5_med_overall
    FROM GroupMedians
    GROUP BY decade, Market
    ORDER BY CASE WHEN Market = 'KOSPI' THEN 1 ELSE 2 END, decade
""").df()

decade_order = ['1990년대', '2000년대', '2010년대', '2020년대']

chart_spread = alt.Chart(decade_spread_df).mark_bar().encode(
    x=alt.X('decade:N', title='시대 구분', sort=decade_order),
    y=alt.Y('avg_size_spread:Q', title='대형주-소형주 중위 수익률 스프레드 (Q1 - Q5)'),
    color=alt.Color('Market:N', title='시장', sort=MARKET_ORDER),
    xOffset=alt.XOffset('Market:N', sort=MARKET_ORDER),
    tooltip=[
        alt.Tooltip('Market:N', title='시장'),
        alt.Tooltip('decade:N', title='시대 구분'),
        alt.Tooltip('avg_size_spread:Q', title='Q1-Q5 스프레드', format='+.2%'),
        alt.Tooltip('q1_med_overall:Q', title='Q1 중위수익률', format='+.2%'),
        alt.Tooltip('q5_med_overall:Q', title='Q5 중위수익률', format='+.2%')
    ]
).properties(
    width=560,
    height=280,
    title='시대별 대형주(Q1) 대비 소형주(Q5) 중위 수익률 프리미엄 스프레드'
)
chart_spread

3.4 실증 분석 해석

  • 복권형 왜도(Lottery Skewness) 현상 실증: Q5(소형주, 하위 20%) 집단의 시가총액 평균 성장률은 코스닥 +71.91%, 코스피 +43.31%(명목 종가 평균 +42.64%, +36.10%)에 달하지만, 권리락 보정 복리 수익률 중위값은 코스닥 +1.12%, 코스피 +3.68%에 그친다. 극소수 급등 테마주가 산술평균을 40%p 이상 끌어올릴 뿐, 중위권 이하 대다수 소형주의 실질 성과는 미미한 우측 꼬리 왜도 구조를 보인다.
  • 시장별 분위 수익률 형태 차이 (코스피 U자형 vs 코스닥 평균 회귀): 코스피는 복리 중위 수익률 기준 Q1 대형주(+0.24%, 시총 성장률 중위값 +1.49%)와 Q5 소형주(+3.68%)가 양수를 기록하고 중형주 구간인 Q2(-2.70%), Q3(-1.18%), Q4(-1.02%)가 음수를 기록하는 U자형 구조를 띤다. 반면 코스닥은 연초 시총 상위 집단인 Q1(-11.59%), Q2(-10.05%), Q3(-8.04%), Q4(-4.68%)의 중위 수익률이 일제히 음수를 기록하며, 전년도 급등으로 상위 분위에 진입한 대장주들이 당해 연도에 강한 밸류에이션 조정(평균 회귀)을 겪는 특성을 드러낸다.
  • 유상증자·메자닌 발행에 따른 주주가치 희석(Share Dilution): 코스닥 Q5의 시가총액 성장률 중위값은 +5.98%이나 주가 복리 수익률 중위값은 +1.12%로 4.86%p의 격차가 존재한다(코스닥 Q4 역시 시총 -0.45% 대 주가 -4.68%로 4.23%p 격차). 잦은 유상증자와 전환사채(CB)·신주인수권부사채(BW) 주식 전환으로 인해 기업의 시가총액 외형은 유지되더라도 기존 주주의 주당 가치는 구조적으로 희석됨을 입증한다.
  • 시대별 규모 프리미엄(Q1 - Q5 스프레드)의 체제 변화: 코스피는 중국 고성장 수혜가 집중된 2000년대에 대형주가 소형주를 연평균 +3.55%p(시대 중위 Q1 +35.50% vs Q5 +3.27%) 앞섰으나, 박스피 시기인 2010년대에는 중소형주 강세로 -12.08%p 역전되었다. 이후 2020년대 들어 패시브 자금 유입과 반도체·밸류업 대형주 장세가 전개되며 Q1(+2.35%)이 Q5(-3.39%)를 연평균 +2.75%p 앞서는 대형주 우위 체제로 복귀했다.

4 소속시장별 신규 상장 종목의 생존성(Survivorship)

4.1 분석 설계

신규 상장 종목이 시장에 진입한 뒤 얼마나 오래 상장을 유지하는지, 상장 이후 시가총액 최고점(Peak)과 최저점(Trough)에 도달하기까지 걸리는 시간이 어떠한 분포를 보이는지 소속시장 및 초기 시가총액 5분위 규모별로 규명한다.

  • 절단 데이터(Censoring) 처리:
    • 각 소속시장의 데이터 수집 시작일(코스피 1995-05-02 855개 종목, 코스닥 1996-07-01 54개 종목)에 이미 존재하던 종목은 실제 상장일을 알 수 없으므로 좌측 절단(Left-censored) 데이터로 분류하여 신규 상장 코호트에서 제외한다. (first_date > mkt_min_date 조건 적용)
    • 데이터셋 마지막 거래일(2026-11-06) 기준 최근 7일 이내 거래가 유지되는 종목은 우측 절단(Right-censored, 상장 유지 중) 상태이며, 이전에 거래가 종료된 종목은 상장폐지(Delisted) 상태로 구분한다.
  • 주요 산출 변수:
    • 초기 시가총액 5분위(init_size_quintile): 상장 연도 및 소속시장 내 상장 첫날 시가총액 기준 5분위수(Q1 대형 공모주 ~ Q5 소형 공모주)
    • 상장 유지기간(duration_years): 최초 거래일부터 최종 거래일까지의 경과 연수
    • 최고점 도달 기간(days_to_peak): 최초 거래일부터 역대 최고 시가총액 기록일까지 걸린 일수
    • 최저점 도달 기간(days_to_trough): 최초 거래일부터 역대 최저 시가총액 기록일까지 걸린 일수

4.2 종목별 생애주기 및 최고·최저점 도달 기간

Code
# 1) 시장별 최초 수집일 이후 신규 상장 종목 원천 코호트 테이블 (5분위 기준)
new_listings_df = con.execute(f"""
    WITH MarketBounds AS (
        SELECT Market, MIN(Date) AS mkt_min_date, MAX(Date) AS mkt_max_date
        FROM '{PARQUET_GLOB}'
        WHERE Market IN ('KOSPI', 'KOSDAQ')
          AND Volume > 0
        GROUP BY Market
    ),
    StockLifecycle AS (
        SELECT 
            Code,
            ARG_MIN(Market, Date) AS init_market,
            ARG_MAX(Market, Date) AS last_market,
            ARG_MAX(Name, Date) AS name,
            MIN(Date) AS first_date,
            MAX(Date) AS last_date,
            COUNT(*) AS active_trading_days,
            ARG_MIN(Marcap, Date) AS init_marcap,
            MAX(Marcap) AS peak_marcap,
            ARG_MAX(Date, Marcap) AS peak_date,
            MIN(Marcap) AS trough_marcap,
            ARG_MIN(Date, Marcap) AS trough_date
        FROM '{PARQUET_GLOB}'
        WHERE Market IN ('KOSPI', 'KOSDAQ')
          AND Volume > 0
        GROUP BY Code
    )
    SELECT 
        s.Code,
        s.name,
        s.init_market,
        s.last_market,
        s.first_date,
        s.last_date,
        s.active_trading_days,
        s.init_marcap,
        s.peak_marcap,
        s.peak_date,
        s.trough_marcap,
        s.trough_date,
        EXTRACT(YEAR FROM s.first_date) AS ipo_year,
        DATE_DIFF('day', s.first_date, s.last_date) AS duration_days,
        ROUND(DATE_DIFF('day', s.first_date, s.last_date) / 365.25, 2) AS duration_years,
        DATE_DIFF('day', s.first_date, s.peak_date) AS days_to_peak,
        DATE_DIFF('day', s.first_date, s.trough_date) AS days_to_trough,
        CASE WHEN s.last_date >= m.mkt_max_date - INTERVAL 7 DAY THEN 1 ELSE 0 END AS is_active,
        CASE WHEN s.peak_date <= s.trough_date THEN '선고점 후저점 (피크 후 우하향)' ELSE '선저점 후고점 (저점 후 반등성장)' END AS pattern_type,
        NTILE(5) OVER (
            PARTITION BY EXTRACT(YEAR FROM s.first_date), s.init_market 
            ORDER BY s.init_marcap DESC
        ) AS init_size_quintile  -- 1: 상장시 대형(Q1) ~ 5: 상장시 소형(Q5)
    FROM StockLifecycle s
    JOIN MarketBounds m ON s.init_market = m.Market
    WHERE s.first_date > m.mkt_min_date  -- 시장별 최초 수집일 기존 상장 종목(좌측 절단) 제외
""").df()

ipo_quintile_labels = {
    1: 'Q1 (대형)',
    2: 'Q2 (중대형)',
    3: 'Q3 (중형)',
    4: 'Q4 (중소형)',
    5: 'Q5 (소형)'
}
new_listings_df['quintile_name'] = new_listings_df['init_size_quintile'].map(ipo_quintile_labels)

# 2) 시장별·상장 초기 5분위 규모별 요약 통계 테이블
lifecycle_summary_df = con.execute("""
    SELECT 
        init_market,
        init_size_quintile,
        COUNT(*) AS n_listings,
        SUM(is_active) AS n_active,
        ROUND(AVG(is_active), 4) AS survival_rate,
        ROUND(MEDIAN(duration_years), 2) AS median_duration_years,
        ROUND(MEDIAN(days_to_peak), 0) AS median_days_to_peak,
        ROUND(QUANTILE_CONT(days_to_peak, 0.25), 0) AS q25_days_to_peak,
        ROUND(QUANTILE_CONT(days_to_peak, 0.75), 0) AS q75_days_to_peak,
        ROUND(MEDIAN(days_to_trough), 0) AS median_days_to_trough,
        ROUND(QUANTILE_CONT(days_to_trough, 0.25), 0) AS q25_days_to_trough,
        ROUND(QUANTILE_CONT(days_to_trough, 0.75), 0) AS q75_days_to_trough
    FROM new_listings_df
    GROUP BY init_market, init_size_quintile
    ORDER BY CASE WHEN init_market = 'KOSPI' THEN 1 ELSE 2 END, init_size_quintile
""").df()

lifecycle_summary_df['quintile_name'] = lifecycle_summary_df['init_size_quintile'].map(ipo_quintile_labels)

4.3 시각화 및 해석

Code
# 1) 소속시장별·초기 시총 5분위 규모별 상장 유지기간(Duration) 분포 플롯
ipo_quintile_order = ['Q5 (소형)', 'Q4 (중소형)', 'Q3 (중형)', 'Q2 (중대형)', 'Q1 (대형)']

chart_duration = alt.Chart(new_listings_df).mark_boxplot(outliers=False).encode(
    x=alt.X('quintile_name:N', title='상장 초기 시총 5분위 (소형 -> 대형)', sort=ipo_quintile_order),
    y=alt.Y('duration_years:Q', title='상장 유지기간 (년)', axis=alt.Axis(format='.2f')),
    color=alt.Color('init_market:N', sort=MARKET_ORDER, legend=None),
    column=alt.Column('init_market:N', title='최초 상장 시장', sort=MARKET_ORDER)
).properties(
    width=320,
    height=280,
    title='소속시장별·신규 상장 초기 시가총액 5분위(Q5~Q1)에 따른 상장 유지기간 분포'
)
chart_duration
Code
# 2) 신규 상장 후 최고 시총(Peak) 및 최저 시총(Trough) 도달 기간 분포 비교 (히스토그램)
days_melted = new_listings_df.melt(
    id_vars=['init_market', 'quintile_name'],
    value_vars=['days_to_peak', 'days_to_trough'],
    var_name='event_type',
    value_name='days'
)
event_labels = {'days_to_peak': '역대 최고점 도달 기간 (일)', 'days_to_trough': '역대 최저점 도달 기간 (일)'}
days_melted['event_name'] = days_melted['event_type'].map(event_labels)

# 초기 약 13.7년(5,000일) 구간 집중 확대
days_filtered = days_melted[days_melted['days'] <= 5000]

chart_hist = alt.Chart(days_filtered).mark_bar(opacity=0.65).encode(
    x=alt.X('days:Q', bin=alt.Bin(maxbins=50), title='상장일로부터 소요 일수'),
    y=alt.Y('count():Q', stack=None, title='종목 수'),
    color=alt.Color(
        'event_name:N',
        title='도달 사건',
        sort=['역대 최고점 도달 기간 (일)', '역대 최저점 도달 기간 (일)'],
        legend=alt.Legend(orient='top')
    ),
    column=alt.Column('init_market:N', title='최초 상장 시장', sort=MARKET_ORDER),
    tooltip=[
        alt.Tooltip('init_market:N', title='시장'),
        alt.Tooltip('event_name:N', title='도달 사건'),
        alt.Tooltip('count():Q', title='종목 수')
    ]
).properties(
    width=320,
    height=280,
    title='신규 상장 후 최고점(Peak) vs 최저점(Trough) 도달 소요 일수 분포'
)
chart_hist
Code
# 3) 상장 궤적 선후 패턴(선고점 후저점 vs 선저점 후고점) 시장별·5분위별 비중 시각화
pattern_df = con.execute("""
    SELECT 
        init_market,
        quintile_name,
        pattern_type,
        COUNT(*) AS count,
        ROUND(COUNT(*) * 100.0 / SUM(COUNT(*)) OVER (PARTITION BY init_market, quintile_name), 2) AS ratio_pct
    FROM new_listings_df
    GROUP BY init_market, quintile_name, pattern_type
    ORDER BY CASE WHEN init_market = 'KOSPI' THEN 1 ELSE 2 END, quintile_name, pattern_type
""").df()

chart_pattern = alt.Chart(pattern_df).mark_bar().encode(
    x=alt.X('quintile_name:N', title='상장 초기 시총 5분위 (소형 -> 대형)', sort=ipo_quintile_order),
    y=alt.Y('ratio_pct:Q', title='비중 (%)', axis=alt.Axis(format='.2f')),
    color=alt.Color(
        'pattern_type:N',
        title='궤적 패턴',
        legend=alt.Legend(orient='top')
    ),
    column=alt.Column('init_market:N', title='최초 상장 시장', sort=MARKET_ORDER),
    tooltip=[
        alt.Tooltip('init_market:N', title='시장'),
        alt.Tooltip('quintile_name:N', title='시총 5분위'),
        alt.Tooltip('pattern_type:N', title='궤적 패턴'),
        alt.Tooltip('ratio_pct:Q', title='비중 (%)', format='.2f'),
        alt.Tooltip('count:Q', title='종목 수')
    ]
).properties(
    width=320,
    height=280,
    title='신규 상장 종목의 생애주기 궤적 패턴 비중 (IPO 붐-버스트 vs 장기 성장)'
)
chart_pattern

4.4 실증 분석 해석

  • 초기 자본 규모에 비례하는 상장 생존율과 유지기간: 코스피 신규 상장 코호트(1,985개 종목)에서 상장 첫날 시총 상위 20%인 Q1 대형주는 생존율 53.77%, 유지기간 중위값 11.00년(Q2는 51.86%, 11.97년)을 기록한 반면, 하위 20%인 Q5 소형주는 생존율 23.83%, 유지기간 중위값 5.04년으로 생존율이 절반 이하로 급락한다. 코스닥 신규 상장 코호트(3,630개 종목) 역시 Q1~Q3의 생존율(53.18% ~ 54.27%, 유지기간 중위값 6.35 ~ 6.92년) 대비 Q5 소형주의 생존율은 35.24%, 유지기간 중위값은 2.87년에 그친다.
  • 상장 초기 과열과 단기 피크 형성 (IPO Boom and Bust): 전체 신규 상장 종목 가운데 상장 후 단 30일 이내에 생애 최고 시가총액을 기록하고 이후 한 번도 그 고점을 넘지 못한 종목 비율이 코스닥 20.94%, 코스피 16.22%에 달한다. 범위를 상장 후 1년(365일) 이내로 넓히면 코스닥 신규 상장주의 40.30%, 코스피 신규 상장주의 35.72%가 첫 1년 안에 생애 최고점을 형성한다.
  • 코스닥 대형 공모주(Q1)의 고평가 역설(Overpricing Paradox): 코스피 Q1~Q3 상장주는 상장 후 약 1.3년(med_days_trough = 476일) 시점에 저점을 먼저 다진 뒤 3.7~5.5년(med_days_peak = 1,353 ~ 2,009일)에 걸쳐 고점을 높여가는 ‘선저점 후고점(저점 후 반등성장)’ 비율이 59.12% ~ 61.54%로 우세하다. 반면 코스닥 Q1(상장 초기 시총 상위 20% 대형 공모주)은 1사분위수(q25_days_to_peak)가 불과 14일, 중위값(median_days_to_peak)이 437일인 데 반해 최저점 도달 기간 중위값(median_days_to_trough)은 1,014일(약 2.8년)로 역전되어 있으며, 고점을 먼저 찍고 우하향하는 ‘선고점 후저점’ 비중이 56.56%로 전 분위 중 가장 높다. 코스닥 시장에서 높은 공모가와 시장 기대감으로 대형 시총(Q1)에 데뷔한 종목일수록 상장 직후 단기 과열 피크를 형성한 뒤 보호예수 해제와 실적 검증 과정에서 장기 우하향 위험에 크게 노출됨을 시사한다.